Stellen Sie sich vor, Sie legen dieselben Buchstaben auf einen Tisch und ordnen sie zu verschiedenen Wörtern. Die Buchstaben haben sich nicht verändert, die Aussage aber schon. Bei Peptiden ist es ähnlich: Aminosäuren bilden das molekulare Alphabet, Peptidbindungen verbinden die Buchstaben und die Sequenz bestimmt, welche Kette aufgebaut wurde. Zwei Peptidketten können gleich viele Aminosäuren – sogar dieselben Aminosäuretypen – enthalten und dennoch unterschiedliche Moleküle darstellen, weil ihre Reihenfolge verschieden ist.
Deshalb ist eine Peptidsequenz mehr als ein technischer Code. Sie ist das Konstruktionsprotokoll des Moleküls. Um dieses Protokoll sicher zu lesen, helfen drei Grundideen: wie die Bindung entsteht, warum die Kette eine Richtung hat und was sich ändert, wenn sich die Reihenfolge ändert.
Die molekularen Bestandteile einer Aminosäure
Die meisten Aminosäuren besitzen denselben Grundkörper mit einem variablen Teil. Im Zentrum befindet sich ein Kohlenstoffatom. Daran gebunden sind eine Aminogruppe, eine Carboxylgruppe, ein Wasserstoffatom und eine Seitenkette, die häufig mit dem Buchstaben R dargestellt wird. Der gemeinsame Grundkörper lässt sich als Standardverbinder verstehen, die Seitenkette als Merkmal, das jeder Aminosäure ihren eigenen Charakter gibt.
Eine Seitenkette kann klein, eine andere sperrig sein. Manche wechselwirken leicht mit Wasser, andere meiden es; einige können unter bestimmten Bedingungen eine elektrische Ladung tragen. Nach dem Aufbau der Kette beeinflussen diese Unterschiede das Verhalten des Peptids, seine möglichen Formen und sein Erscheinungsbild in Laboranalysen.
Der Moment, in dem eine Peptidbindung entsteht
Eine Peptidbindung entsteht, wenn das Carboxylende einer Aminosäure mit dem Aminoende einer anderen verbunden wird. Dabei verbinden sich kleine Bestandteile beider Aminosäuren und werden als ein Wassermolekül abgegeben. Zurück bleibt eine starke chemische Verbindung, die Peptidbindung. Einfach gesagt: Zwei Bausteine verbinden sich, Wasser wird freigesetzt und die Kette beginnt.
Sobald eine Aminosäure in die Kette eingebaut ist, bezeichnet man sie als Aminosäurerest. Der Begriff Rest ist hilfreich, weil die eingebaute Einheit nicht mehr identisch mit der freien Aminosäure vor der Bindungsbildung ist: Bei der Beschreibung der Kondensation sind die dem Wasser entsprechenden Elemente verloren gegangen.
Aus einer Bindung wird ein Rückgrat
Die Verknüpfung zweier Reste erzeugt ein Dipeptid. Durch einen dritten entsteht ein Tripeptid, und fortgesetzte Kopplung führt zu einer längeren Peptidkette. Das wiederkehrende Muster aus Stickstoff, Alpha-Kohlenstoff und Carbonyl-Kohlenstoff bildet das Peptidrückgrat. Die Seitenketten ragen aus diesem Rückgrat heraus und geben jeder Position ihre besondere Identität.
Das Rückgrat ist keine völlig lockere Schnur. Die Peptidbindung verhält sich teilweise wie eine Doppelbindung; dadurch ist dieser kleine Abschnitt relativ flach und nur eingeschränkt drehbar. Benachbarte Bindungen können sich freier bewegen. Gemeinsam ermöglichen diese festen und beweglichen Abschnitte der Kette, sich zu biegen und verschiedene dreidimensionale Formen einzunehmen, ohne sich wie ein völlig ungebundener Faden zu verhalten.
Jede Peptidsequenz hat eine Richtung
Eine lineare Peptidkette besitzt normalerweise zwei chemisch unterschiedliche Enden. Das Ende mit der verfügbaren Aminogruppe heißt Aminoterminus oder N-Terminus. Das Ende mit der verfügbaren Carboxylgruppe heißt Carboxylterminus oder C-Terminus. Nach wissenschaftlicher Konvention werden Peptid- und Proteinsequenzen vom N- zum C-Terminus geschrieben.
Betrachten wir die Sequenz Gly-Ala-Ser mit drei Resten. Konventionell gelesen befindet sich Glycin am N-Terminus, Alanin in der Mitte und Serin am C-Terminus. Ser-Ala-Gly enthält dieselben drei Resttypen, jedoch in umgekehrter Reihenfolge. Es ist eine andere Sequenz und keine gleichwertige Beschreibung.
Diese Richtung ist beim Vergleich von Etiketten, technischen Spezifikationen, Datenbanken, Syntheseprotokollen oder Analyseberichten entscheidend. Eine rückwärts kopierte Sequenz ist keine harmlose Formatänderung, sondern beschreibt eine andere molekulare Anordnung.
Die Sequenz ist molekulare Information
Eine Sequenz hält fest, welcher Rest jede einzelne Position einnimmt. Wird ein Rest ersetzt, ein anderer eingefügt, einer entfernt oder die Reihenfolge umgekehrt, ändert sich die chemische Identität der Kette. Je nach Position und Austausch kann dies Molekülmasse, Elementzusammensetzung, Nettoladung, Hydrophobie, Löslichkeit, Konformation, chromatografische Retention oder die in einem Forschungsmodell untersuchten Wechselwirkungen beeinflussen.
Deshalb sollte die Formulierung „gleiches Peptid, leicht veränderte Sequenz“ vorsichtig verwendet werden. Eine Sequenzvariante kann eng mit dem Original verwandt sein, ist aber nicht automatisch dasselbe Material. Technische Unterlagen sollten die genaue Sequenz oder eine andere eindeutige Identitätsreferenz enthalten.
Eine Sequenz kann einfach aussehen und dennoch Komplexität erzeugen
Auf dem Papier ist eine Sequenz nur eine Reihe von Buchstabencodes. Das wirkliche Molekül existiert dreidimensional. Nach dem Aufbau der Kette wechselwirken Rückgrat und Seitenketten mit der umgebenden Flüssigkeit und miteinander. Auch Temperatur, Säuregrad (pH), Salze und Konzentration können eine Rolle spielen. Manche Peptide bleiben sehr flexibel, andere bilden eher Biegungen, Spiralen oder kompakte Formen.
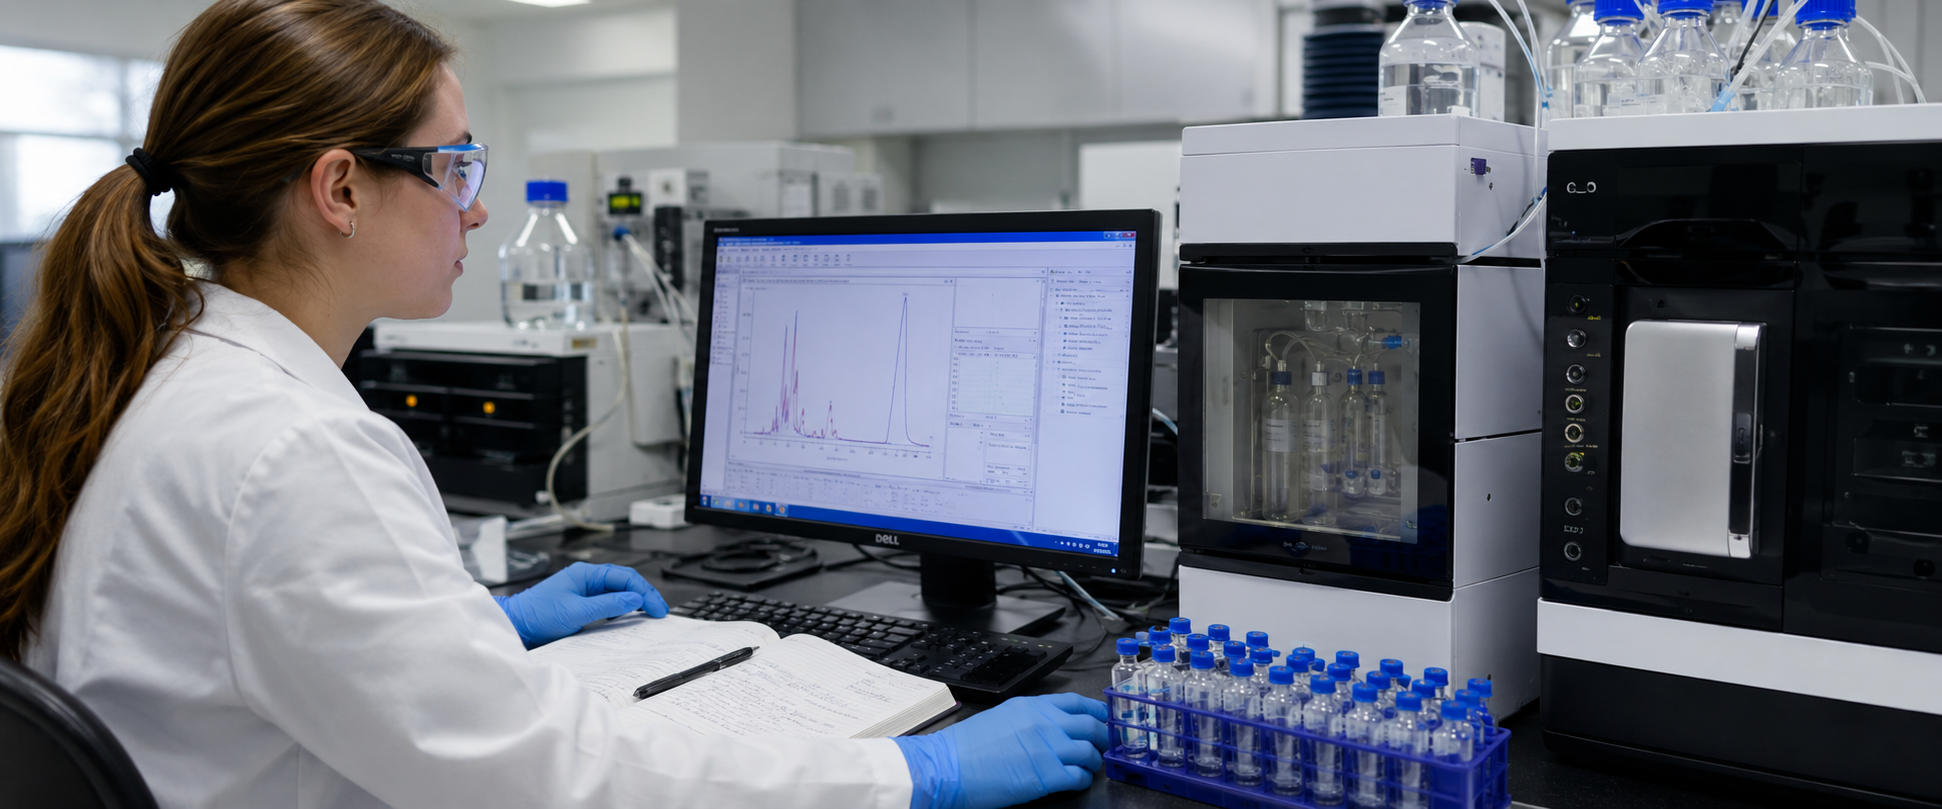
Die Sequenz ist daher die Ausgangsspezifikation, nicht das vollständige Bild des Verhaltens. Sie sagt Forschenden, was aufgebaut werden sollte. Analytische Identitäts- und Reinheitsprüfungen, Massendaten, Chargenunterlagen und Handhabungsbedingungen helfen zu dokumentieren, welches Material tatsächlich vorhanden ist und wie es behandelt wurde.
So lesen Sie eine Sequenz, ohne den Überblick zu verlieren
Beginnen Sie am N-Terminus und gehen Sie zum C-Terminus. Behandeln Sie jeden Code als eine Restposition. Achten Sie darauf, ob die Sequenz Drei-Buchstaben-Codes wie Gly-Ala-Ser oder Ein-Buchstaben-Codes wie GAS verwendet. Groß- und Kleinschreibung, Satzzeichen, Leerzeichen oder Zeilenumbrüche ändern nicht automatisch die Chemie; prüfen Sie jedoch, dass beim Übertragen kein Rest ausgelassen, verdoppelt oder umgekehrt wurde.
Prüfen Sie außerdem die Hinweise rund um die Sequenz. Ein technisches Dokument kann angeben, dass ein Ende modifiziert, die Kette zu einem Ring geschlossen, zwei Positionen durch eine Brücke verbunden oder eine weitere chemische Gruppe hinzugefügt wurde. Zwei Unterlagen können dieselbe zentrale Sequenz zeigen und dennoch unterschiedliche Materialien beschreiben, wenn diese Zusatzangaben nicht übereinstimmen.
Häufige Missverständnisse
• „Dieselben Aminosäuren bedeuten dasselbe Peptid.“ Nicht unbedingt. Die Reihenfolge gehört zur Identität.
• „Eine Peptidbindung ist nur ein flexibler Verbinder.“ Sie besitzt partiellen Doppelbindungscharakter und eine eingeschränkte Drehbarkeit.
• „Die Sequenz kann in beide Richtungen gelesen werden.“ Die Standardnotation verläuft vom N- zum C-Terminus.
• „Die Sequenz allein beweist den Inhalt eines Fläschchens.“ Sie bezeichnet die beabsichtigte molekulare Identität; Analyse- und Chargendokumente liefern Nachweise zu einem bestimmten Material.
• „Reinheit und Sequenz sind dieselbe Messung.“ Reinheit schätzt den relativen Anteil einer Zielkomponente nach einer angegebenen Methode; die Sequenz beschreibt Identität und Reihenfolge der Reste.
Praktische Checkliste zur Sequenzprüfung
• Bestätigen Sie die vollständige Sequenz und ihre Richtung von N nach C.
• Prüfen Sie, ob Ein- oder Drei-Buchstaben-Codes verwendet werden.
• Vergleichen Sie jede Position, nicht nur Sequenzlänge oder Produktname.
• Dokumentieren Sie terminale Modifikationen, Zyklisierung, Brücken, Markierungen oder andere angegebene Strukturmerkmale.
• Ordnen Sie die Sequenzreferenz dem genauen Produkt, der Stärke, der Charge bzw. dem Los und dem Analyseprotokoll zu.
• Bewahren Sie die ursprüngliche technische Quelle auf, um Übertragungsfehler zu verringern.
Kernaussage
Peptide entstehen, wenn Aminosäuren durch Peptidbindungen zu einer gerichteten Kette verbunden werden. Das wiederkehrende Rückgrat liefert den Rahmen, die Seitenketten geben jeder Position ihren chemischen Charakter und die N-zu-C-Sequenz hält die Reihenfolge fest. Diese Reihenfolge ist keine dekorative Information, sondern ein zentraler Bestandteil der molekularen Identität.
Wer dieses Prinzip versteht, kann Produktetiketten, Sequenzblätter, Syntheseprotokolle und Analysedokumente leichter vergleichen. Der nächste PrimePeptidesHub-Artikel baut darauf auf und trennt drei häufig verwechselte Begriffe: Peptididentität, Peptidreinheit und die zu ihrer Bewertung eingesetzten Labortests.